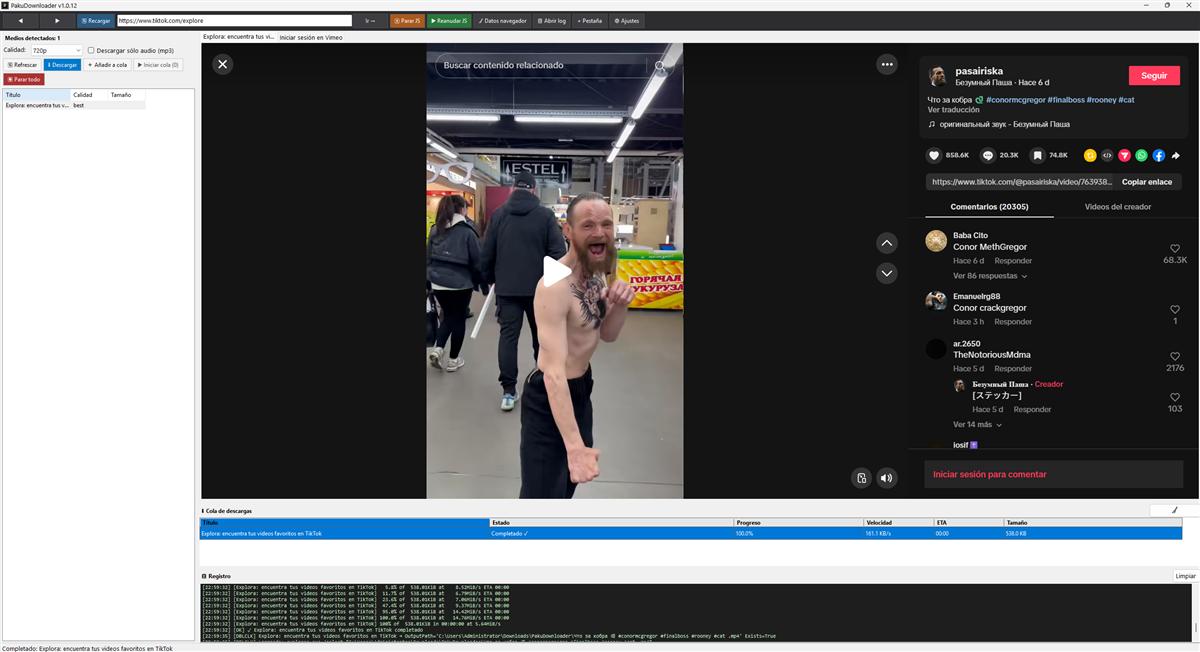
Aplicación gratuita para Windows con navegador integrado. Navegas a cualquier página, detecta los vídeos automáticamente y los descarga con un clic. Sin copiar URLs, sin línea de comandos, sin configurar nada. También transcribe a texto y traduce a 15 idiomas — todo en tu ordenador, sin enviar nada a ningún servidor.
01 — Qué hace
PakuDownloader incluye un navegador web real — el mismo motor que usa Edge. Navegas a cualquier página como lo harías normalmente y el programa detecta los vídeos en silencio. Cuando encuentra algo descargable, aparece en la lista de abajo. Pulsas descargar y listo.
No necesitas saber qué URL tiene el vídeo, no necesitas abrir la terminal, no necesitas instalar Python ni nada extra. El instalador no pide permisos de administrador y se mete en tu carpeta de usuario.
02 — De dónde descarga
Vídeo habitual — YouTube (vídeos sueltos y listas de reproducción), TikTok, Instagram, Twitter/X, Twitch (directos, VODs y clips), Vimeo, Dailymotion, Facebook, Reddit, Rumble, Bilibili, Odysee y otras.
Televisión española — RTVE a la carta, Atresplayer (Antena 3, La Sexta), Mitele (Telecinco, Cuatro). Sin anuncios en la descarga.
Música y podcasts — SoundCloud, Bandcamp, Mixcloud. Canciones sueltas y playlists completas en MP3.
Formación online — Udemy, Coursera, LinkedIn Learning, Khan Academy, TED. Para Udemy, Coursera y LinkedIn tienes que haber iniciado sesión previamente en el navegador integrado.
Streams técnicos — HLS (televisiones y eventos en directo), RTSP, RTMP, Wowza y WebRTC. Si el navegador puede reproducirlo, PakuDownloader puede grabarlo.
Páginas de vídeos sobre anatomía, como por ejemplo... ya tú sabe XDDDD.
03 — Transcripción y traducción
Además de descargar, el programa puede transcribir cualquier vídeo o audio a texto y traducirlo. Todo corre en tu ordenador: ningún dato sale a internet, no hace falta cuenta en ningún servicio ni pagar por API keys.
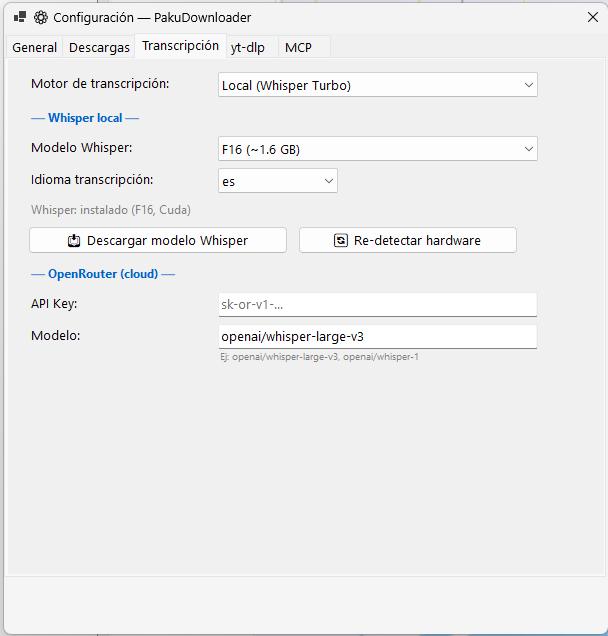
Transcripción con Whisper Turbo. La primera vez, el programa se descarga automáticamente la herramienta y el modelo de IA (entre 550 MB y 1,6 GB según la calidad que elijas; solo una vez). A partir de ahí transcriben sin conexión. Funciona en cualquier ordenador — con o sin GPU. Si tienes una tarjeta NVIDIA te ofrece la versión CUDA, que va bastante más rápido; no hace falta instalar el CUDA Toolkit ni nada por el estilo, la descarga ya lo trae todo. Sin GPU, tira en CPU sin problema. El resultado es un .srt con los tiempos y un .txt con el texto limpio, guardados junto al vídeo. Puedes activar la transcripción automática al descargar, o transcribir cualquier fichero de audio o vídeo que ya tengas en el ordenador.
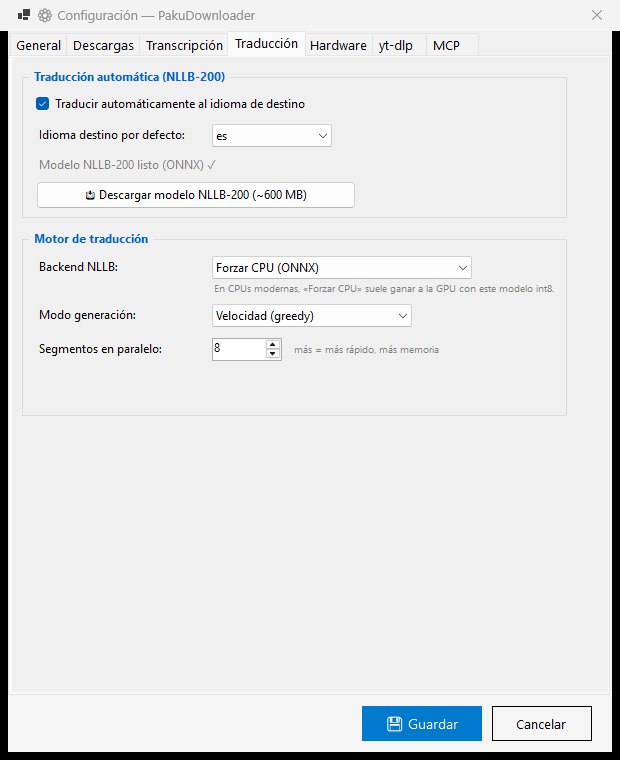
Traducción con NLLB-200. Después de transcribir — o partiendo de un .srt que ya tengas — el programa puede traducir a otro idioma: español, inglés, francés, alemán, italiano, portugués, catalán, gallego, euskera, neerlandés, japonés, chino, coreano, ruso y árabe. El modelo (~600 MB) también se descarga una sola vez. Los tiempos del subtítulo se conservan tal cual, y el fichero traducido se guarda con el nombre del idioma destino: video.es.srt, video.en.srt, etc. Corre nativo con ONNX Runtime: en CPU siempre, y en GPU a través de DirectML (vale cualquier tarjeta compatible con DirectX 12, sea NVIDIA, AMD o Intel). Curiosamente, en procesadores modernos la CPU suele ganarle a la GPU con este modelo cuantizado — puedes probar las dos y quedarte con la que te vaya mejor.
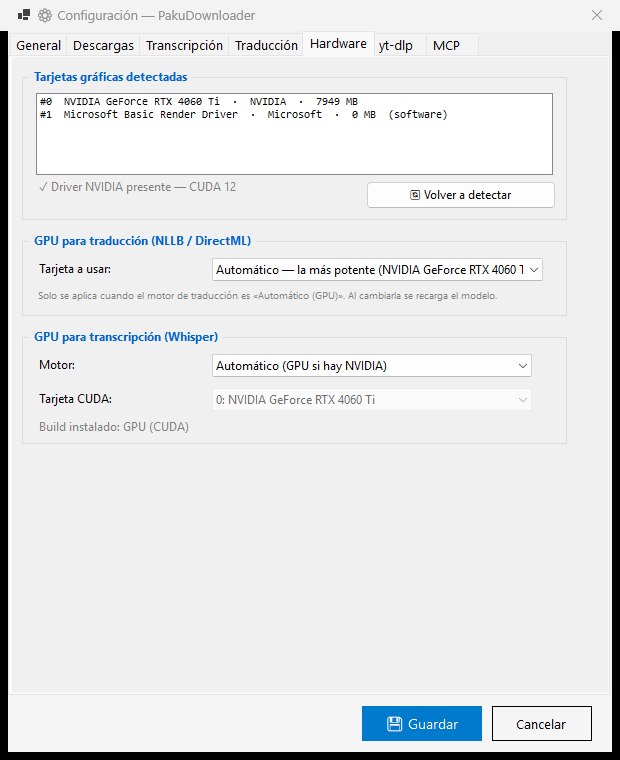
Elige tú la tarjeta gráfica. Si el equipo tiene dos GPUs — el caso típico del portátil con Intel integrada y una NVIDIA dedicada — la pestaña Hardware lista las que hay y te deja decidir cuál usa cada motor. Por defecto escoge la más potente, no la primera que enumera Windows, que era justo el motivo por el que en muchos portátiles nunca se usaba la tarjeta buena.
Tanto las transcripciones como las traducciones aparecen en la lista principal con barra de progreso, tiempo estimado y botón de cancelación.
04 — Detección de medios: JS + sniffer de red
El núcleo diferencial respecto a lanzar yt-dlp desde la terminal es el sistema de detección. Hay dos mecanismos que trabajan en paralelo desde el momento en que abres una pestaña:
Escáner activo en JavaScript. Al completarse la carga de cada página, el programa inyecta un script que busca medios en el DOM: elementos <video>, <audio>, <source>, metadatos JSON-LD (objetos, arrays, @graph), atributos og:video y twitter:player, enlaces directos a ficheros de vídeo, embeds de iframe, y APIs de reproductores populares (Video.js, JW Player, HLS.js, Plyr, Brightcove). El escaneo se repite tres veces: al cargar (t=0), a los 3 segundos y a los 10 segundos, para capturar vídeos que la página inyecta mediante SPA navigation o XHR después del load inicial.
Sniffer pasivo de red. En paralelo, el programa intercepta las peticiones del navegador mediante WebResourceRequested y detecta URLs de streaming (.m3u8, .mpd, .mp4) conforme el navegador las solicita, sin esperar al escaneo JS. Este canal captura vídeos que el JS no puede ver porque vienen de iframes cross-origin o de peticiones XHR de reproductores nativos.
Si la misma URL llega por dos fuentes distintas con clasificaciones distintas, el sistema resuelve el conflicto por FormatRank: youtube > m3u8 > mp4 > unknown. La entrada existente se upgradea a la clasificación de mayor rango, evitando un bug antiguo donde las descargas de YouTube acababan como GET del HTML.
05 — Streams: HLS, RTSP, RTMP y Wowza
Para streams no-YouTube, el routing va directamente a ffmpeg. El programa distingue entre VOD y live descargando el manifest HLS y buscando la directiva #EXT-X-ENDLIST: presente ⇒ VOD, ausente ⇒ live. La diferencia importa en el formato de salida:
- VOD → MP4 con
-movflags +faststartpara que el fichero sea reproducible antes de terminar de descargarse. - Live → MPEG-TS (
-f mpegts), que sigue siendo reproducible aunque el proceso muera a media grabación. Los MP4 necesitan un moov atom al final; los TS no.
Las flags de reconexión (-reconnect 1 -reconnect_streamed 1 -reconnect_at_eof 1 -reconnect_delay_max 30) hacen que ffmpeg sobreviva a drops cortos de red y a refreshes de token de los CDNs. RTSP usa -rtsp_transport tcp porque UDP da drops esporádicos en redes locales con QoS agresivo.
Wowza Streaming Engine merece mención especial. Muchos servidores de streaming corporativos y de broadcast corren Wowza, que añade tokens de autenticación en la query string (wowzatokenhash=, hdnea=) y firmas propietarias. PakuDownloader detecta Wowza tanto por fingerprints de URL (/_definst_/, prefijos /smil:, /mp4:, chunks nombrados como chunklist_w\d+) como por el header de respuesta Server: WowzaStreamingEngine/*. Los fragmentos hijo se filtran de la lista para que solo aparezca el master playlist.
06 — WebRTC: grabando Flashphoner WCS
Este es el caso más complejo que resuelve PakuDownloader. Flashphoner Web Call Server es una plataforma de streaming comercial que sirve vídeo por WebRTC — DTLS/SRTP sobre UDP, señalizado por WebSocket. Ni yt-dlp ni ffmpeg pueden grabarlo directamente porque no hablan el protocolo. La solución tiene tres piezas:
1. Captura del handshake. WcsSniffer se conecta al protocolo CDP de WebView2 y escucha los frames WebSocket de todas las pestañas. Cuando detecta la secuencia connect + playStream en el mismo WebSocket, emite un DetectedMedia con Format="wcs-webrtc" que incluye el JSON crudo de ambos mensajes. El usuario ve el stream en la lista de medios igual que cualquier otro vídeo.
2. Sidecar Python. wcs_recorder.py (compilado a wcs_recorder.exe con PyInstaller, ~40 MB) recibe el JSON del handshake capturado. Hace replay verbatim del mensaje connect — que lleva el appKey, tokens del operador y versión del cliente — para autenticarse igual que el navegador real. Luego genera su propia RTCPeerConnection con aiortc, crea una SDP offer, inyecta esa SDP en el mensaje playStream capturado (sustituyendo solo el campo data[0].sdp y el mediaSessionId), y completa la negociación ICE/DTLS/SRTP. El audio y vídeo recibidos se escriben a MP4 con PyAV.
3. Integración en la UI. Al pulsar descargar, DownloadService lanza el sidecar y escucha líneas [PROG] duration:N bytes:N en su stdout para actualizar la columna Tamaño del grid en tiempo real. Al pulsar Detener, escribe q\n a stdin del sidecar — el mismo mecanismo que usa ffmpeg — para que PyAV finalice el moov atom correctamente antes de salir.
La razón de hacer replay en lugar de reimplementar el cliente Flashphoner desde cero es práctica: cada deployment WCS tiene campos custom (tokens, JWT, fingerprints propios del operador) que varían por sitio. Capturar y replayear el connect verbatim los maneja todos automáticamente.
07 — Congelar JavaScript para streams en directo
Muchos sitios de streaming en directo (televisiones, cámaras, plataformas de eventos) tienen watchdogs en JavaScript que detectan inactividad o ausencia de heartbeat y desconectan la sesión. Si el JS detecta que llevas mucho tiempo sin interactuar, cierra el WebSocket de señalización, expira el token o recarga el reproductor — interrumpiendo la grabación que tienes en marcha.
El botón Parar JS del toolbar congela la pestaña activa inyectando un script que:
- Guarda los originales de
setTimeout,setInterval,requestAnimationFrameyqueueMicrotaskenwindow.__pdh_jsFreeze. - Los sustituye por noops y cancela todos los IDs activos.
- Bloquea nuevas llamadas a
fetch(devuelve una Promise que no resuelve),EventSourceyWebSocket(lanzan al construirse).
Los fragmentos HLS ya en vuelo no se ven afectados — ffmpeg los sigue recibiendo. Los watchdogs que iban a desconectarte, no. El botón Reanudar JS restaura los originales desde el snapshot. Si la página se recarga, el window nuevo está limpio y no hace falta hacer nada.
08 — Servidor MCP: descarga desde Claude Code
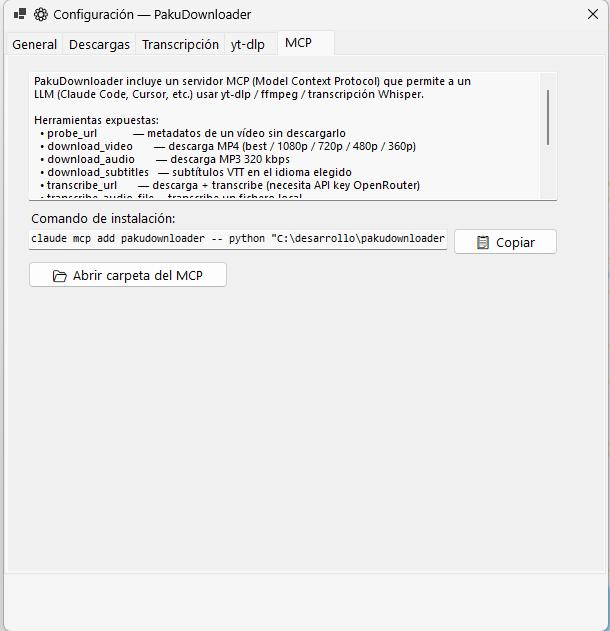
PakuDownloader incluye un servidor MCP en Python (mcp_server/server.py) que expone sus capacidades a cualquier LLM. Con él puedes pedirle a Claude Code que descargue vídeos, extraiga audio, transcriba o traduzca contenido sin abrir la aplicación de escritorio.
Las herramientas disponibles:
probe_url(url)                          → metadatos sin descargar
download_video(url, quality)            → MP4 (best/1080p/720p/480p/360p)
download_audio(url)                     → MP3 320 kbps
download_subtitles(url, language)       → VTT
transcribe_audio_file(file_path, target_lang?)  → texto vía Whisper local; target_lang traduce con NLLB-200
transcribe_url(url, language, target_lang?)     → descarga + transcripción + traducción en un paso
translate_text(text, source_lang, target_lang)  → traducción con NLLB-200 local
list_recent_downloads(limit)            → historial de descargas
get_settings()                          → configuración actual
diagnostics()                           → versiones y rutas de yt-dlp/ffmpeg
El MCP comparte configuración con la app de escritorio — misma carpeta de salida, mismas cookies del navegador. Para instalarlo en Claude Code:
pip install -r C:\ruta\pakudownloader\mcp_server\requirements.txt
claude mcp add pakudownloader -- python C:\ruta\pakudownloader\mcp_server\server.py
Una vez registrado, las herramientas aparecen como mcp__pakudownloader__*. Llama a diagnostics primero para confirmar que yt-dlp y ffmpeg son visibles desde el servidor.
09 — Ajustes
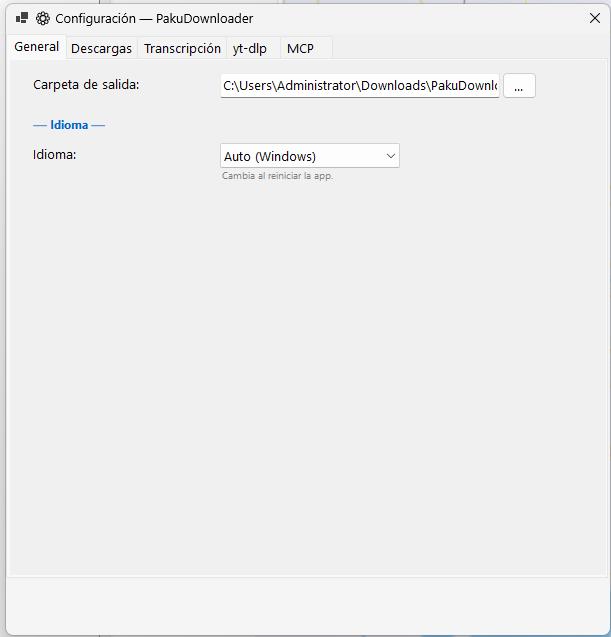
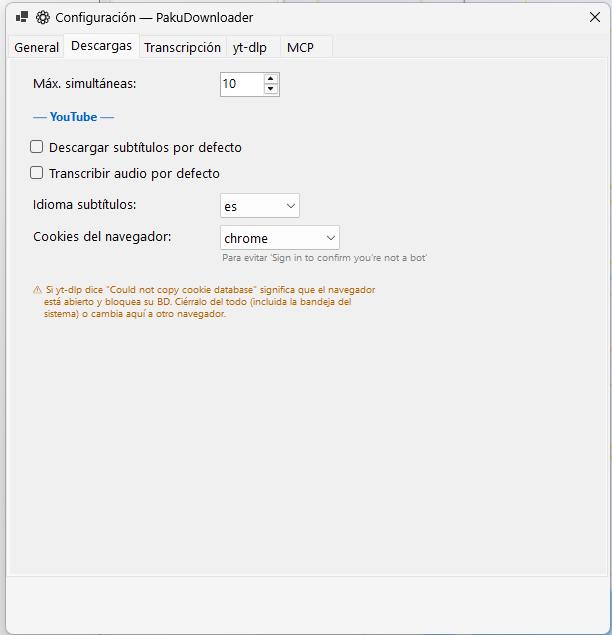
El diálogo de Ajustes está dividido en siete pestañas:
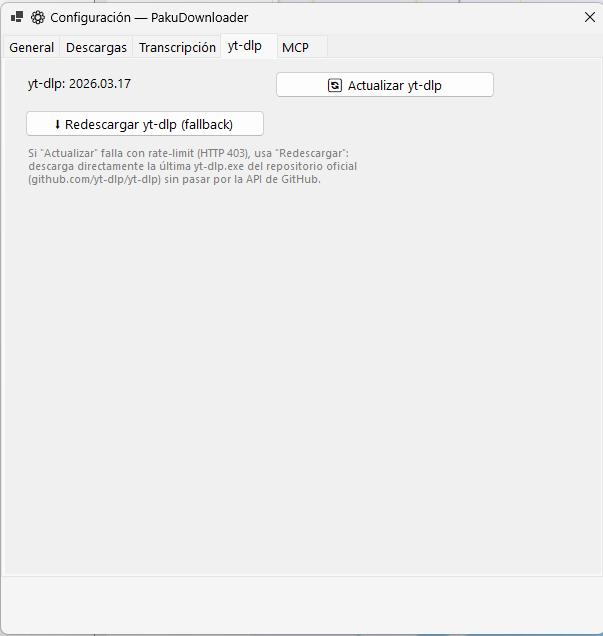
Nota sobre yt-dlp: desde 2026 yt-dlp necesita un runtime JavaScript para descifrar ciertos formatos de YouTube. Sin él avisa con No supported JavaScript runtime could be found, cae a un extractor de respaldo y pierde formatos — de ahí el desconcierto de que una versión antigua funcionase mejor que la recién actualizada. El instalador ya incluye Deno dentro de la carpeta del programa (no toca el PATH del sistema ni instala nada aparte), así que no hay que hacer nada. La pestaña yt-dlp muestra su estado y, si esa carpeta se borrase, permite reinstalarlo con un botón.